오과장입니다. 요즘 IT 실무진이나 개발자들 사이에서 데스크탑 그래픽카드인 'RTX 5060 Ti 16GB'와 '로컬 LLM' 조합을 검색하는 빈도가 눈에 띄게 늘었습니다. 이유는 단순합니다. Llama 3, Qwen 2.5, DeepSeek 같은 오픈소스 거대언어모델을 사내 기밀 유출 걱정 없이 내 기기에서 직접 돌리려면 비디오 메모리(VRAM) 16GB가 사실상 가장 현실적인 진입선이기 때문입니다.
하지만 회사와 카페, 회의실, 연구실을 오가야 하는 직장인이나 개발자에게 육중한 데스크탑 타워는 그림의 떡입니다. 결국 노트북에서 로컬 LLM을 돌려야 하는데, 데스크탑 전용 카드인 5060 Ti 16GB를 무작정 기다리거나 400만 원대 플래그십 랩탑만 쳐다보고 있을 수는 없습니다. 오늘은 이동성과 작업 효율을 모두 챙길 수 있는 현실적인 로컬 AI 구동 노트북 3대를 골라 명확한 기준선으로 비교해 드리겠습니다.
- 실속 가성비형: 에이수스 TUF F16 (차세대 RTX 5060 탑재, 7B~8B 모델 4비트 양자화 서빙 최적)
- 고부하 쿨링 안정형: HP 오멘 16 (인텔 i7 + 템페스트 쿨링, 긴 연속 배치 추론 쓰로틀링 차단)
- 통합 메모리 종결형: Apple 맥북 프로 14 (VRAM 한계 없는 Unified Memory, 14B~32B 모델 무소음 구동)
노트북으로 로컬 LLM 돌릴 때 진짜 봐야 할 3가지
스펙표의 벤치마크 점수는 잊으셔도 좋습니다. 터미널 열고 Ollama나 vLLM, LM Studio를 띄우는 순간 판가름 나는 건 딱 세 가지입니다.
첫째, VRAM 적재 용량입니다. 7B~8B 크기의 LLM(Q4_K_M 양자화 기준)은 기본 5~6GB의 VRAM을 차지합니다. VRAM이 8GB 미만이면 모델이 시스템 RAM으로 넘어가면서 토큰 생성 속도가 초당 30토큰에서 2~3토큰으로 폭락합니다. 속 터집니다. 못 씁니다.
둘째, 시스템 메모리 확장성입니다. 로컬에서 ComfyUI나 RAG(검색 증강 생성) 파이프라인, 임베딩 벡터 DB를 함께 띄우면 16GB 시스템 RAM은 금세 바닥납니다. 나중에 32GB나 64GB로 직접 증설할 수 있는 듀얼 슬롯이 필수입니다.
셋째, 지속 냉각 설계입니다. 10만 토큰 단위의 문서를 분석하거나 코딩 에이전트를 몇 시간씩 연동하면 GPU가 쉬지 않고 풀로드를 뜁니다. 쿨링이 부실하면 15분 만에 클럭이 반토막 납니다.
1. [실속 가성비형] 에이수스 2026 TUF 게이밍 F16 (RTX 5060)
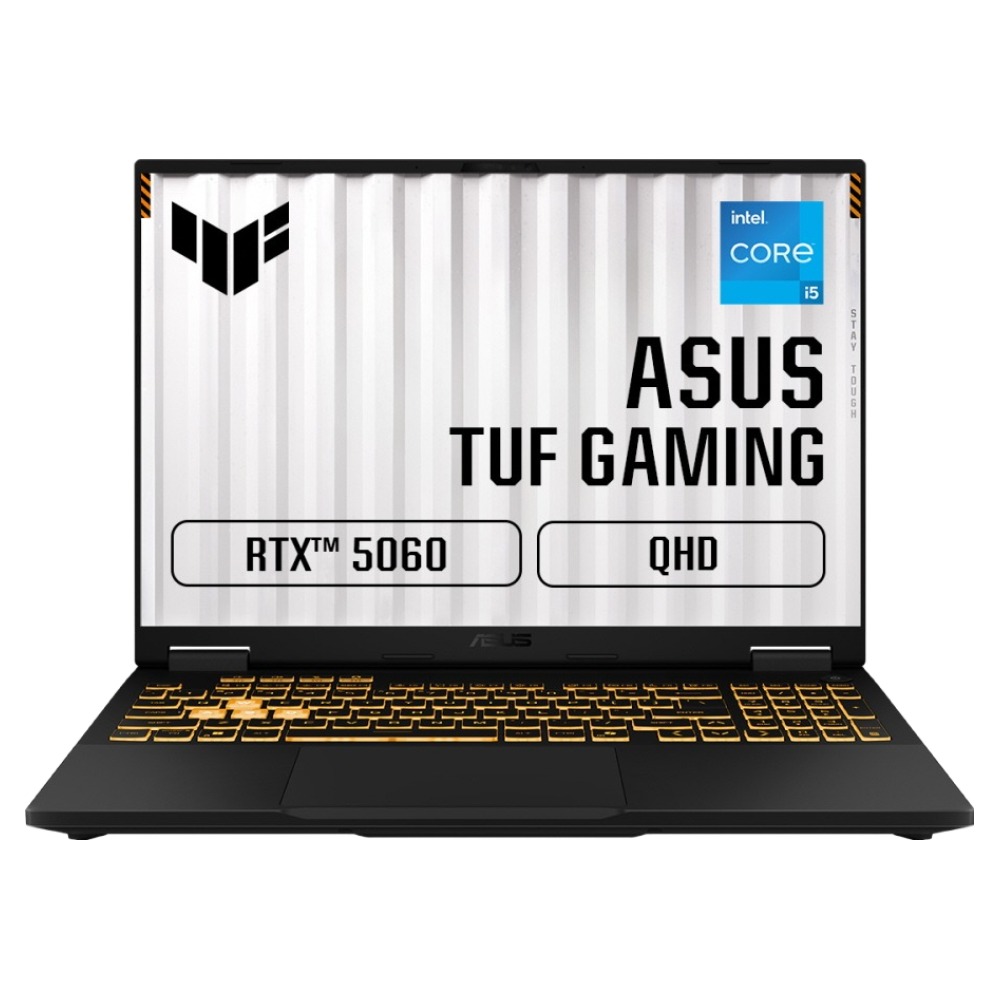
가장 현실적인 예산으로 차세대 지포스 아키텍처에 진입할 수 있는 기종입니다. 데스크탑 5060 Ti 16GB를 구축하려면 본체와 모니터까지 200만 원 중후반이 훌쩍 넘어가는데, 이 제품은 단일 패키지로 차세대 RTX 5060 모바일 GPU를 품었습니다.
체감 성능이 확실합니다. Llama-3-8B-Instruct 4비트 양자화 모델을 올렸을 때 버벅임 없이 초당 35~40토큰을 안정적으로 뿜어냅니다. 코딩 어시스턴트나 사내 문서 요약용으로는 차고 넘치는 반응 속도입니다. 특히 하판 분리가 쉬워 기본 16GB 메모리를 32GB나 64GB로 손쉽게 자가 업그레이드할 수 있다는 점이 엔지니어 입장에서 큰 강점입니다.
- 좋은 점: 250만 원대 최신 RTX 5060 탑재, RAM/SSD 듀얼 슬롯 확장성, 밀스펙 인증 내구성
- 주의할 점: Free DOS 모델이라 윈도우 직접 설치 필요, 고부하 시 팬 소음 존재
- 실구매가 확인: 약 2,599,000원 선 (옵션: i5-14세대 / 16GB / 512GB)
2. [고부하 쿨링 안정형] HP 2025 오멘 16 (코어i7 + RTX 5060)
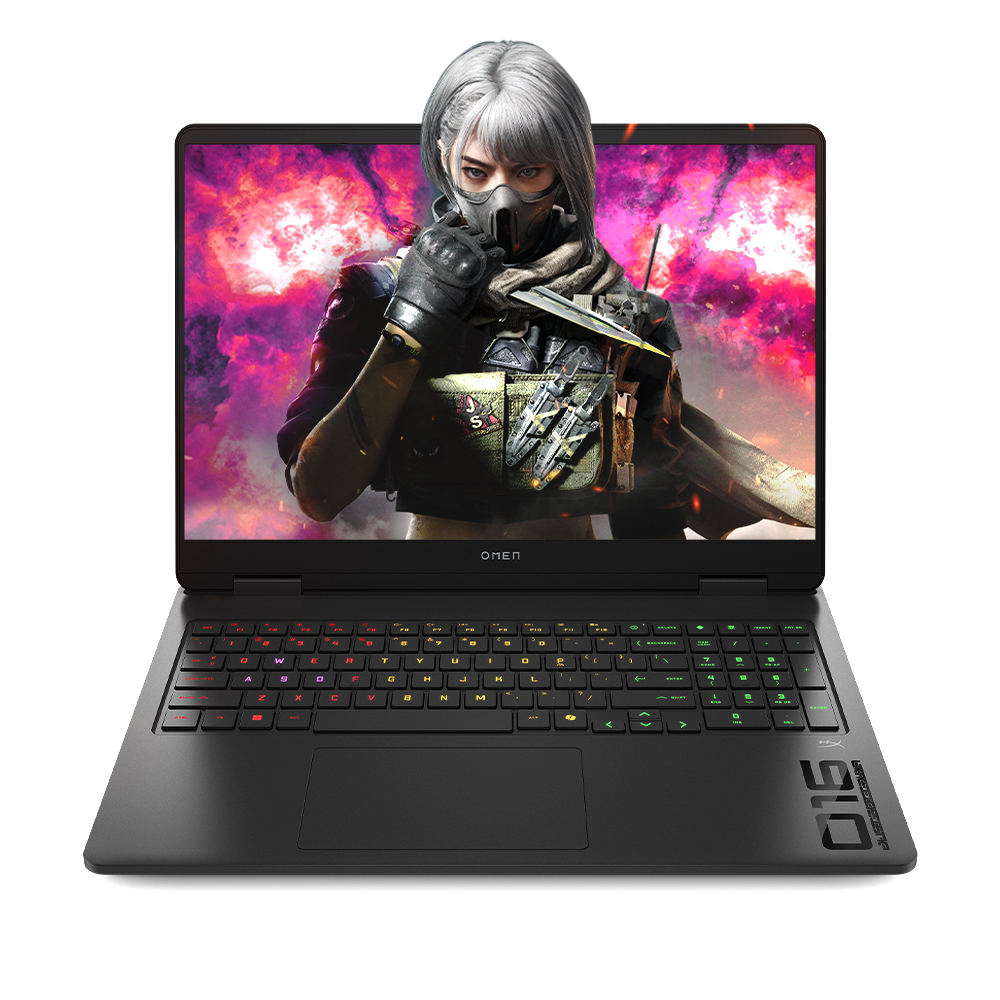
단순 테스트가 아니라 로컬 LLM을 백그라운드 서버처럼 하루 종일 띄워두거나 대량의 문서를 배치 처리해야 한다면 쿨링 설계가 승패를 가릅니다. HP 오멘 16은 인텔 14세대 i7 프로세서의 강력한 멀티코어와 오멘 고유의 템페스트 쿨링 솔루션을 결합했습니다.
독서실에서는 조용하게 문서 작업 모드로 쓰다가, 책상에서 풀로드로 AI 추론을 돌릴 때는 3면 통풍구와 대형 히트파이프로 열을 빠르게 빼냅니다. 키보드 팜레스트 쪽으로 열이 올라오지 않아 타이핑할 때 불쾌감이 없습니다. 16인치 16:10 비율 화면 덕분에 좌측에 코드 에디터를 띄우고 우측에 웹 UI나 로그 콘솔을 나란히 배열하기에 아주 쾌적합니다.
- 좋은 점: i7 멀티코어로 전처리 작업 우수, 장시간 가동에도 안정적인 템페스트 쿨링, 고급스러운 섀시 마감
- 주의할 점: 어댑터 무게를 포함하면 3kg에 육박해 매일 도보 이동하기엔 묵직함
- 실구매가 확인: 약 2,699,000원 선 (옵션: i7-14세대 / 16GB / 512GB)
3. [통합 메모리 종결형] Apple 맥북 프로 14
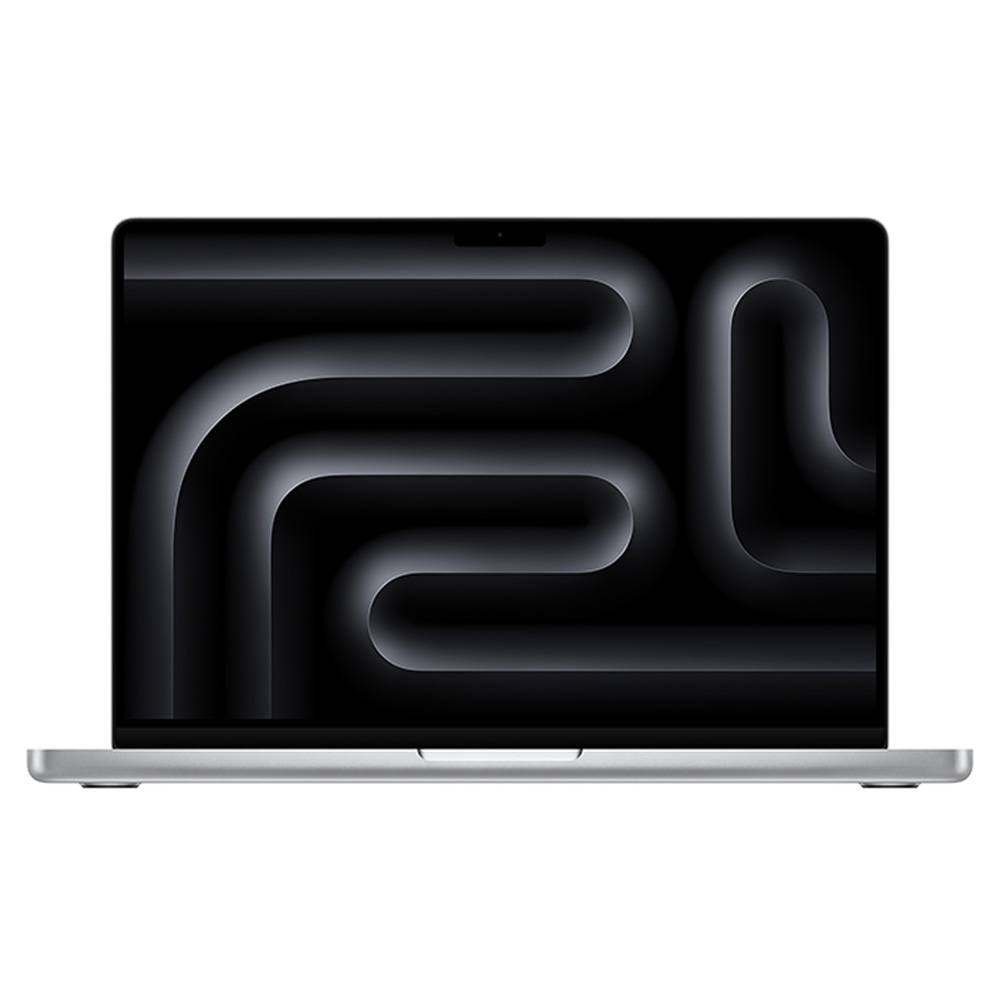
데스크탑 5060 Ti의 16GB VRAM마저 부족하다고 느끼거나, 14B~32B 이상의 거대 모델을 노트북에서 구동하고 싶다면 사실상 유일한 정답지는 맥북 프로입니다. 애플 실리콘의 '통합 메모리(Unified Memory)' 구조는 CPU와 GPU가 램 전체를 공유합니다. 8GB/16GB VRAM이라는 물리적 벽 자체가 없습니다.
Ollama와 애플 전용 MLX 프레임워크를 활용하면 32B 모델조차 무리 없이 VRAM으로 인식해 로딩합니다. 무엇보다 충전기를 뽑고 배터리 상태로 KTX 좌석에서 3시간 동안 코딩 에이전트를 돌려도 성능 저하가 전혀 없습니다. 팬이 도는지조차 모를 정도로 조용합니다. 예산 여유가 있고 모바일 AI 개발 환경을 종결짓고 싶다면 후회 없는 투자입니다.
- 좋은 점: 통합 메모리로 거대 모델 구동 가능, 배터리 구동 시 성능 유지, 압도적인 정숙성과 디스플레이 품질
- 주의할 점: 높은 가격대, CUDA 전용 라이브러리 일부는 설정 번거로움 존재, 메모리 자가 증설 불가
- 실구매가 확인: 400만 원대 중반 (전문가용 고용량 메모리 구성)
자주 하는 질문 (Q&A)
Q. 랩탑용 RTX 5060 8GB VRAM으로도 최신 LLM이 원활하게 돌아가나요?
A. 네, 7B~8B 크기의 모델(Llama 3 8B, Qwen 2.5 7B 등)을 Q4_K_M 4비트 양자화로 돌리면 VRAM 5.5GB 안쪽에서 초당 30토큰 이상의 쾌적한 속도가 나옵니다. 단, 14B 이상 모델은 8GB VRAM에 통째로 올라가지 않으므로 맥북 통합 메모리나 데스크탑 고용량 카드가 유리합니다.
Q. 윈도우 게이밍 노트북 vs 맥북, 로컬 AI 작업에는 어느 쪽이 더 실용적인가요?
A. CUDA 생태계(ComfyUI, PyTorch 원시 코드 등)를 바로바로 쓰려면 윈도우 게이밍 노트북이 세팅 스트레스가 적습니다. 반면 14B~32B 대형 모델 추론과 이동 중 배터리 작업, 조용한 도서관 환경을 원하신다면 맥북의 통합 메모리가 압도적으로 편합니다.
Q. 시스템 램 16GB로 충분할까요?
A. 부족합니다. LLM 자체는 VRAM에 올리더라도, 크롬 탭 수십 개와 파이썬 가상환경, 벡터 데이터베이스가 돌면 16GB는 금방 찹니다. 윈도우 노트북을 고르신다면 구매 직후 32GB 이상으로 업그레이드하는 것을 적극 권장합니다.
제품 소개 및 구매 가이드 요약
제품 한줄 소개: 5060 Ti 16GB 수준의 AI 연산 갈증을 휴대용 환경에서 풀어주는 3대 대표 랩탑
추천 대상: 로컬에서 보안 걱정 없이 오프라인 LLM을 돌리며 이동 업무를 해야 하는 개발자 및 실무진
비추천 대상: 단순 웹 서핑이나 유튜브 시청, 가벼운 엑셀 문서 작성만 하는 라이트 유저
구매 전 체크 3가지:
- 내가 주로 돌릴 모델의 파라미터 크기 (7B~8B급이면 RTX 5060으로 충분, 14B 이상이면 맥북 통합 메모리 고려)
- 자주 작업하는 장소의 소음 민감도 (조용한 환경 중심이면 맥북, 고정 거치 중심이면 오멘/TUF)
- 시스템 메모리 자가 증설 계획 (윈도우 모델 선택 시 32GB 램 추가 비용 감안)