오과장입니다. 오늘은 최근 개발자와 AI 엔지니어들 사이에서 가장 뜨거운 질문, "내 노트북에서 로컬 LLM(대형 언어 모델)을 쾌적하게 굴리려면 대체 어떤 스펙을 사야 하는가?"에 대한 현실적인 기준을 짚어드립니다.
요즘 오픈소스 AI 진영의 기세가 무섭습니다. 중국 알리바바의 Qwen 2.5부터 딥시크(DeepSeek R1), 메타 라마 3.1(Llama 3.1)까지 유료 클라우드 모델 턱밑까지 따라붙었습니다. 사내 보안 규정상 민감한 코드를 외부 API로 보낼 수 없거나, 매달 나가는 API 구독료를 아끼기 위해 개인 PC에서 Ollama나 LM Studio를 띄우는 분들이 급증했습니다.
그런데 현장에서 보면 안타까운 실수가 반복됩니다. "일반 사무용 슬림북 16GB 램으로도 Ollama 깔면 쌩쌩 돌아가겠죠?" 단호하게 말씀드립니다. 안 됩니다. 돈 낭비입니다. 일반 내장 그래픽 슬림북에 14B 모델 하나만 올려도 1분 만에 팬이 비명을 지르고, 한 줄 출력하는 데 30초씩 걸립니다. 일상 작업은커녕 복장만 터집니다.
- 로컬 LLM은 CPU 속도가 아니라 전용 VRAM 용량과 메모리 대역폭에서 승패가 갈립니다.
- 7B~8B 입문 모델은 16GB 시스템으로 버티지만, 코딩 실전용 14B~32B 모델은 최소 24GB~36GB 이상 메모리가 필수입니다.
- 조용한 이동성과 초대용량 모델 구동은 맥북 프로 14, CUDA 연산 속도와 호환성은 HP 오멘 16, 가성비 입문은 ASUS TUF A16이 정답입니다.
로컬 LLM 노트북 고를 때 절대 속지 말아야 할 3가지
노트북 제조사 상세 페이지의 화려한 NPU TOPS 숫자만 보고 덜컥 결제했다간 피눈물 흘립니다. 로컬 모델 구동의 본질은 따로 있습니다.
첫째, 메모리 용량이 깡패입니다. 양자화(4-bit)된 Qwen 2.5 14B 모델 하나를 메모리에 올리는 데만 순수하게 약 9~10GB가 필요합니다. 여기에 컨텍스트 윈도우 캐시와 OS 기본 점유율까지 더하면 16GB 램은 시작하자마자 바닥납니다. 메모리가 1MB라도 부족하면 운영체제는 가상 메모리(스왑)를 쓰기 시작하고, 그 순간 초당 토큰 속도는 1/10 토막이 납니다.
둘째, 메모리 대역폭(Bandwidth)입니다. 매 토큰을 생성할 때마다 모델 가중치 수십 기가바이트를 통째로 읽어 들여야 합니다. 일반 윈도우 노트북의 DDR5 램 대역폭은 보통 50~80GB/s 수준에 그치지만, 애플 실리콘 Pro/Max 칩셋은 150~300GB/s 이상, 외장 지포스 GDDR6/7 VRAM은 400~500GB/s를 훌쩍 넘깁니다. 대역폭이 좁으면 아무리 좋은 GPU 코어를 달아도 병목이 걸립니다.
셋째, 쿨링 지속력과 TGP입니다. 로컬 LLM 추론은 일반 게임처럼 그래픽 부하가 오르락내리락하는 게 아닙니다. 프롬프트를 던지고 답변을 받는 내내 GPU와 메모리를 100% 한계치까지 쥐어짭니다. 얇은 경량 노트북은 3분만 지나도 스로틀링이 걸려 속도가 곤두박질칩니다.
1. 대용량 모델 구동과 조용한 이동성의 끝판왕: Apple 맥북 프로 14
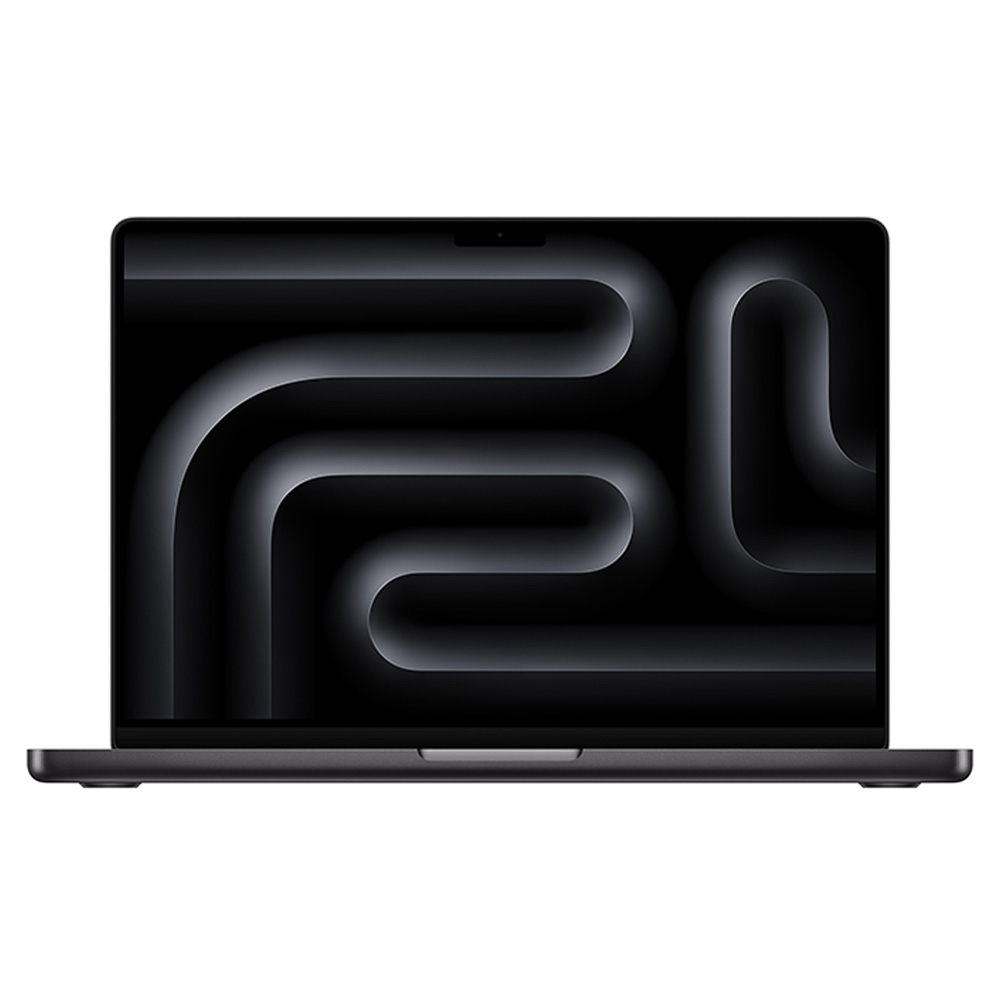
AI 연구원들과 시니어 개발자들이 카페나 비행기 안에서 맥북을 펼쳐놓고 로컬 모델을 돌리는 데는 다 이유가 있습니다. 통합 메모리(Unified Memory) 구조 덕분입니다.
일반 윈도우 노트북은 시스템 램이 64GB라도 외장 GPU VRAM이 8GB에 묶여 있으면 14B 이상 모델을 GPU에 통째로 얹지 못합니다. 반면 맥북 프로는 전체 메모리를 GPU가 그대로 비디오 메모리처럼 끌어다 씁니다. 24GB, 36GB, 48GB 메모리를 장착한 맥북에서는 Qwen 2.5 14B는 물론 32B 모델까지 온보드 GPU로 부드럽게 돌아갑니다.
무엇보다 KTX나 회의실에서 배터리 모드로 돌려도 성능 하락이 거의 없고, 팬 소음이 독서실 수준으로 조용합니다. 충전기 없이 백팩 하나 메고 나가서 오프라인 AI 워크스페이스를 꾸리기엔 대안이 없습니다.
[장점] 통합 메모리 구조로 32B급 중대형 모델 구동 가능 / 압도적인 배터리 효율과 무소음에 가까운 쿨링 / 최상급 Liquid Retina XDR 디스플레이
[단점] 구매 후 메모리 업그레이드 절대 불가 / 고용량 메모리 옵션 선택 시 가격 급상승
[추천 대상] 장소 불문 배터리로 로컬 LLM을 띄워 코딩 보조나 사내 기밀 문서 요약을 돌려야 하는 개발자·연구원
2. 압도적인 토큰 생성 속도와 CUDA 생태계: HP 2026 오멘 16
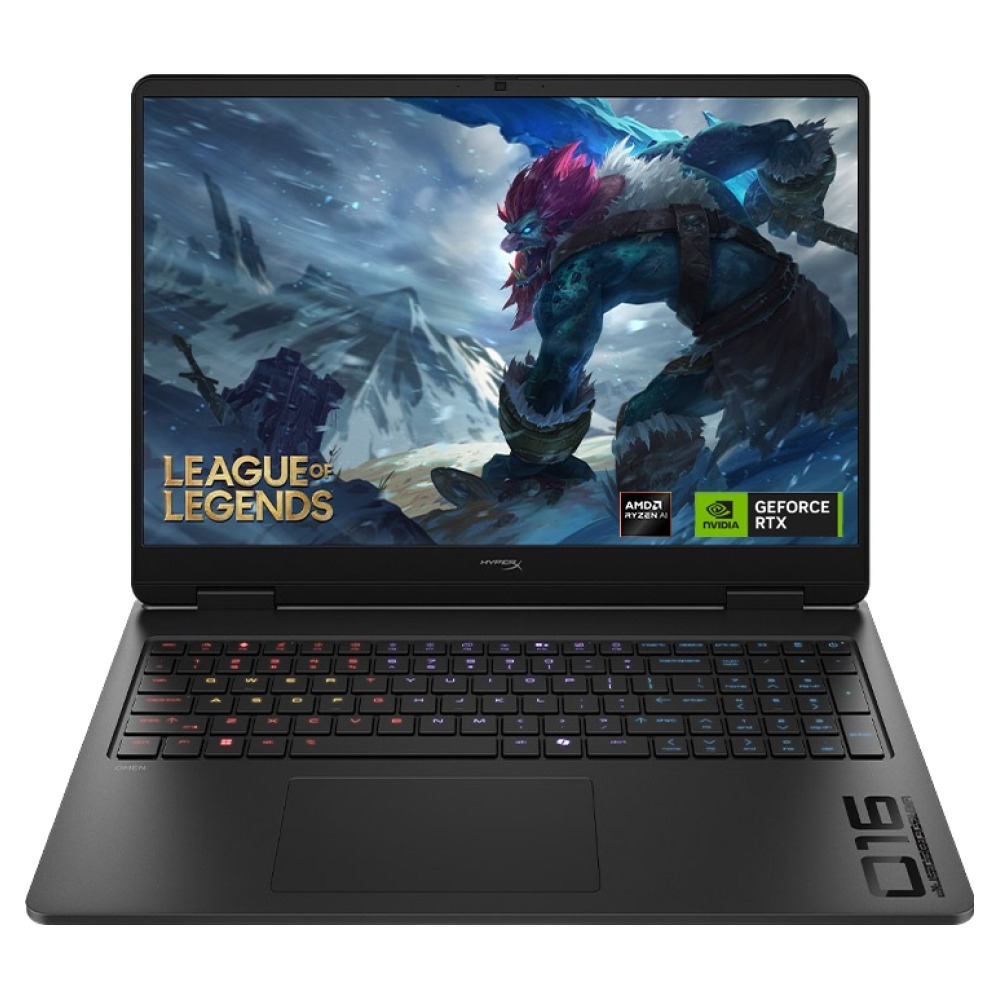
"그래도 AI는 엔비디아(NVIDIA) CUDA 아닙니까?" 맞습니다. 순수 연산 속도와 프레임워크 호환성 측면에서 엔비디아의 벽은 여전히 높습니다.
HP 오멘 16은 최신 아키텍처 기반의 지포스 RTX 5070 외장 그래픽과 24GB 대용량 메모리를 조합한 고성능 머신입니다. 파이토치(PyTorch), 텐서RT-LLM(TensorRT-LLM), vLLM 등 최신 가속 엔진을 돌릴 때 초당 토큰 생성 속도(tokens/second)가 시원시원합니다. 체감이 꽤 큽니다.
특히 8B~14B급 모델을 양자화하여 VRAM에 꽉 채워 올렸을 때 답변이 쏟아져 나오는 속도는 애플 실리콘을 가뿐히 앞섭니다. 오프라인 상태에서 복잡한 파이썬 스크립트 디버깅이나 실시간 에이전트 루프를 돌릴 때 답답함이 전혀 없습니다. 게다가 오멘 특유의 듀얼 팬 쿨링 설계 덕분에 장시간 추론 부하를 걸어도 클럭을 든든하게 유지합니다.
[장점] 엔비디아 CUDA/텐서코어 기반의 압도적인 토큰 생성 속도 / 24GB 넉넉한 램 구성 / 훌륭한 쿨링과 발열 억제력
[단점] 2.3kg대 무게와 묵직한 충전 어댑터 / 고부하 연산 시 회의실에서 눈치 보이는 팬 소음
[추천 대상] 파이토치 및 허깅페이스 생태계에서 초당 생성 속도가 생명인 엔지니어, 데스크톱 대용 고성능 랩톱을 찾는 분
3. 7B~8B 입문 및 RAG 개발 가성비 종결자: 에이수스 2026 TUF 게이밍 A16
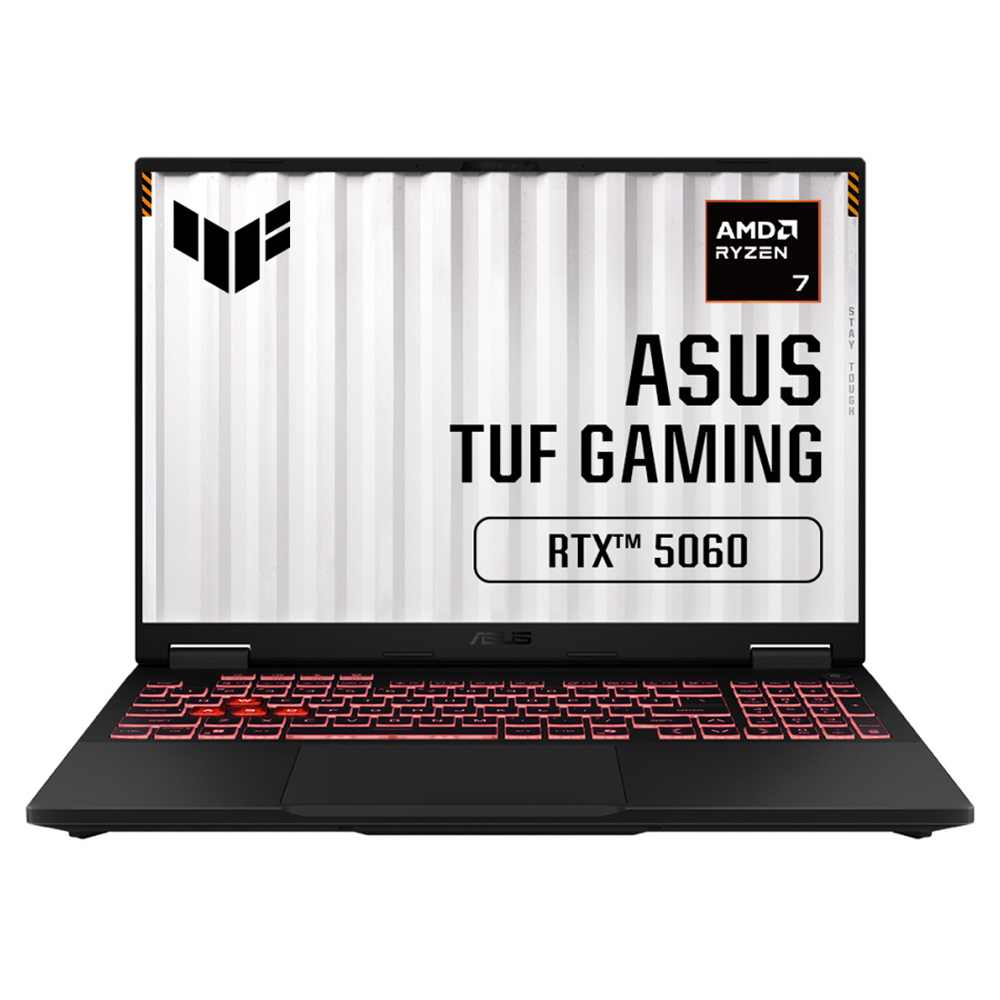
"처음부터 300~400만 원씩 쓰기는 너무 부담스러운데, 현실적인 입문기는 없을까요?" 그 해답이 바로 에이수스 TUF 게이밍 A16입니다.
최신 라이젠 프로세서와 차세대 지포스 RTX 5060을 탑재하여 200만 원대 초중반에 진입 가능한 최강의 가성비 모델입니다. Ollama 환경에서 가장 널리 쓰이는 Llama 3.1 8B, Qwen 2.5 7B, Gemma 2 9B 모델을 아주 쾌적하게 구동합니다.
여기에 칭찬하고 싶은 핵심 장점이 하나 더 있습니다. 듀얼 메모리 슬롯 지원입니다. 맥북처럼 납땜되어 나오는 온보드 메모리와 달리, 필요할 때 언제든 뒷판을 열어 32GB나 64GB DDR5 메모리로 업그레이드할 수 있습니다. 시스템 램을 넉넉하게 꽂아두면 가벼운 파인튜닝(LoRA)이나 대용량 벡터 데이터베이스(RAG) 구축 작업까지 무리 없이 커버합니다.
[장점] 합리적인 가격대에 최신 RTX 5060 탑재 / 사용자가 직접 교체 가능한 듀얼 램 슬롯 / 튼튼한 하우징 내구성
[단점] 기본 16GB 구성 시 추후 램 증설 권장 / 상대적으로 투박한 게이밍 감성 디자인
[추천 대상] 7B~8B 소형 모델로 로컬 LLM 개발을 시작하는 컴퓨터공학과 학생 및 주니어 개발자
- 배터리로 14B~32B 모델 조용하게 돌린다: Apple 맥북 프로 14
- CUDA 기반 빠른 토큰 생성과 AI 파이프라인 개발: HP 2026 오멘 16
- 200만 원대 가성비로 7B~8B 입문 및 램 증설: 에이수스 TUF 게이밍 A16
자주 하는 질문 (Q&A)
Q. 슬림형 경량 노트북(인텔 에보, 갤럭시북 등)에서는 로컬 LLM이 아예 안 돌아가나요?
A. 3B 이하 초미니 모델은 돌아갑니다. 하지만 실무에서 의미가 있는 7B 이상 모델은 1초에 1~2토큰 나올까 말까 한 속도로 기어갑니다. 실사용 목적으로는 권장하지 않습니다.
Q. 맥미니 M4 데스크톱과 맥북 프로 중 고민입니다.
A. 고정된 자리에서만 쓴다면 맥미니 M4가 가성비에서 압승입니다. 하지만 사내 미팅룸, 카페, 출장지 등 어디서나 오프라인으로 모델을 띄워야 한다면 배터리 구동이 완벽한 맥북 프로가 유일한 답입니다.
Q. 윈도우 노트북 VRAM 8GB로 Qwen 2.5 14B를 돌리면 어떻게 되나요?
A. 8GB VRAM을 초과하는 가중치 레이어가 일반 시스템 램으로 밀려납니다(Offloading). 그 순간 PCI 익스프레스 대역폭 병목이 생기면서 토큰 속도가 뚝 떨어집니다. 14B 이상은 최소 12GB~16GB VRAM이나 맥북 통합 메모리를 권장합니다.
결국 핵심은 이겁니다. 내 주력 작업이 어떤 크기의 모델인지(7B vs 14B 이상), 그리고 이동 중에 배터리로 돌릴 일이 많은지에 따라 선택하시면 후회가 없습니다. 장바구니 담기 전에 꼭 스펙 기준을 재확인하세요.