오과장입니다. 오늘은 최근 개발자와 AI 엔지니어 커뮤니티를 가장 뜨겁게 달구고 있는 화두, 바로 Mac mini M4에서 Qwen 2.5 로컬 LLM 구동 실전 가이드를 준비했습니다.
요즘 오픈소스 언어 모델 판도가 완전히 뒤집혔습니다. 중국 알리바바가 내놓은 Qwen 2.5 코딩·추론 모델이 오픈AI의 유료 모델 턱밑까지 따라붙으면서, 사내 보안 규정이나 API 비용 때문에 로컬 PC에 직접 모델을 올려 쓰려는 분들이 폭발적으로 늘었습니다. 그리고 그 종착지로 지목된 하드웨어가 바로 손바닥만 한 Mac mini M4입니다.
하지만 커뮤니티 장바구니 인증글을 보면 아슬아슬합니다. "기본형 16GB 사서 Ollama로 Qwen 14B나 32B 쌩쌩 돌릴 수 있겠죠?" 단호하게 선을 긋고 시작합니다. 안 됩니다. 돈 낭비입니다. 16GB 깡통 모델을 사서 중형 로컬 LLM을 돌리겠다는 생각은 첫날부터 피눈물을 부릅니다. 오늘 실무에서 직접 굴려본 현실적인 하드웨어 마지노선을 짚어드립니다.
- 통합 메모리의 압도적 가성비: 엔비디아 RTX 4090 24GB 글카 하나 살 돈으로 32GB~48GB 통합 VRAM 환경을 손에 쥡니다.
- 16GB 기본형의 명확한 한계: 7B 초소형 모델은 여유롭지만, 실무 코딩에 쓸 만한 Qwen 14B·32B는 메모리 스왑 걸려 거북이가 됩니다.
- 실무 추천 마지노선: 가성비 취미 개발자는 24GB M4, 실무 풀타임 코딩 에이전트는 M4 Pro 48GB가 가장 돈값 하는 선택입니다.
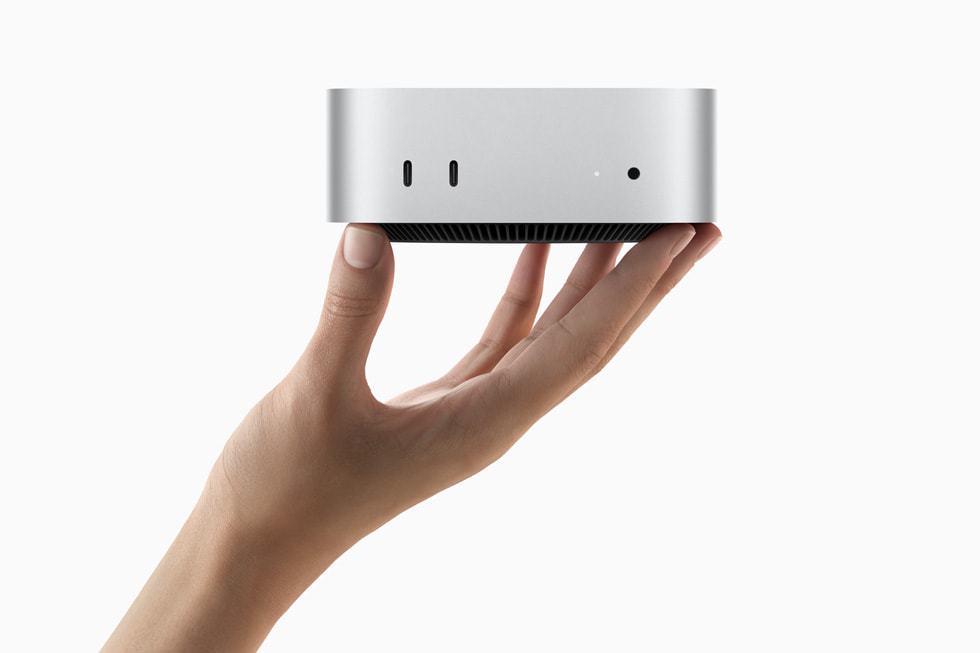
왜 엔비디아 대신 맥미니인가: 통합 메모리(UMA)의 마법
로컬 PC에서 LLM을 구동할 때 가장 큰 병목은 GPU 연산 속도가 아니라 VRAM(비디오 메모리) 용량입니다. 윈도우 데스크톱에서 엔비디아 그래픽카드로 32B 파라미터 양자화(Q4_K_M) 모델을 올리려면 최소 24GB VRAM이 필요합니다. RTX 4090이나 RTX 3090 중고를 찾아 헤매야 하고, 파워 서플라이 1000W에 본체 소음과 겨울철 난방기 수준의 열기를 감당해야 합니다.
여기서 애플 실리콘의 통합 메모리 구조가 빛을 발합니다. 맥미니는 CPU와 GPU가 램 전체를 한 덩어리로 공유합니다. 48GB 메모리를 장착한 M4 Pro 맥미니라면 운영체제가 쓰는 4~6GB를 제외하고 약 38~40GB를 통째로 VRAM처럼 할당할 수 있습니다. 엔비디아 진영에서 이 정도 VRAM을 확보하려면 엔터프라이즈 워크스테이션용 A6000이나 수백만 원짜리 멀티 GPU 세팅을 해야 합니다.
게다가 전력 소모와 소음이 사기적입니다. 책상 한구석에 24시간 켜두고 슬랙 봇이나 개인 코딩 어시스턴트로 굴려도 유휴 전력이 5W 안팎입니다. 풀로드로 Ollama 토큰을 뿜어내도 50W 내외로 조용합니다. 독서실 같은 방 안에서 팬 소음 때문에 식은땀 흘릴 일도 없습니다.
- Qwen 2.5 7B (Q4): 필요 VRAM 약 5.5GB → 16GB 맥미니 완벽 구동 (초당 30~40 토큰, 체감 쾌적)
- Qwen 2.5 14B (Q4): 필요 VRAM 약 10GB → 24GB 맥미니 필수 (16GB는 OS와 충돌해 SSD 스왑 발생)
- Qwen 2.5 32B (Q4): 필요 VRAM 약 20GB → 32GB~48GB 권장 (실무 코딩 추론 최적 체감 구간)
- Qwen 2.5 72B (Q4): 필요 VRAM 약 44GB → 64GB 맥미니 M4 Pro 이상 필수
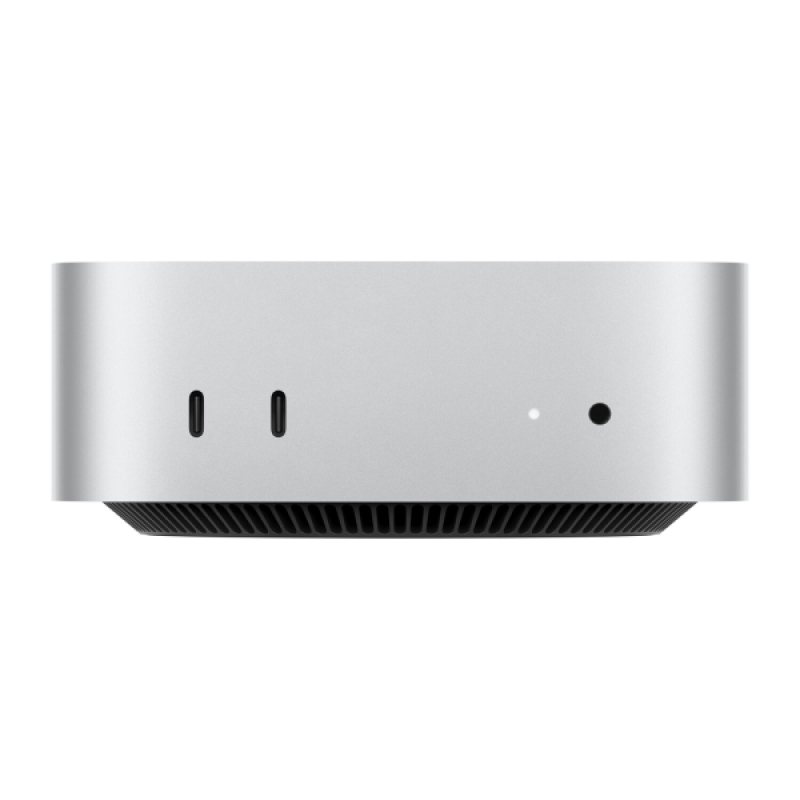
16GB 기본형을 사면 땅을 치고 후회하는 이유
많은 분들이 유튜브나 블로그의 "M4 기본형 16GB 탑재로 갓성비 등극!"이라는 문구만 보고 덜컥 지갑을 엽니다. 일반 사무나 웹서핑, 라이트룸 사진 보정 용도라면 16GB는 차고 넘치는 사양이 맞습니다. 하지만 로컬 LLM은 완전히 다른 영역입니다.
Ollama나 LM Studio를 띄우는 순간, macOS 운영체제와 백그라운드 프로세스가 기본 4~5GB를 점유합니다. 남는 여유 메모리는 기껏해야 10~11GB 남짓입니다. 이 상태에서 Qwen 2.5 14B(약 9.5GB) 모델을 올리고 컨텍스트 윈도우(토큰 창)를 8k, 16k로 늘리면 어떻게 될까요? 여유 메모리가 바닥나며 SSD 가상 스왑으로 넘어갑니다.
그 순간부터 초당 25토큰으로 술술 나오던 답변이 초당 1~2토큰으로 뚝 떨어집니다. 한 글자씩 뜸 들이며 모래시계 도는 화면을 보고 있으면 숨이 턱 막힙니다. 로컬 LLM의 생명은 즉각적인 반응 속도인데, 스왑이 걸리는 순간 클라우드 무료 API 쓰는 것보다 못한 애물단지가 됩니다.
- M4 기본형 (16GB): 번역, 텍스트 요약 등 7B 이하 경량 모델 및 일반 업무용.
- M4 업그레이드형 (24GB): Qwen 14B 완벽 커버. 개인 개발자 가성비 골든 크로스.
- M4 Pro (48GB/64GB): Qwen 32B 및 72B까지 공략 가능한 현업 AI 개발자 종결 머신.
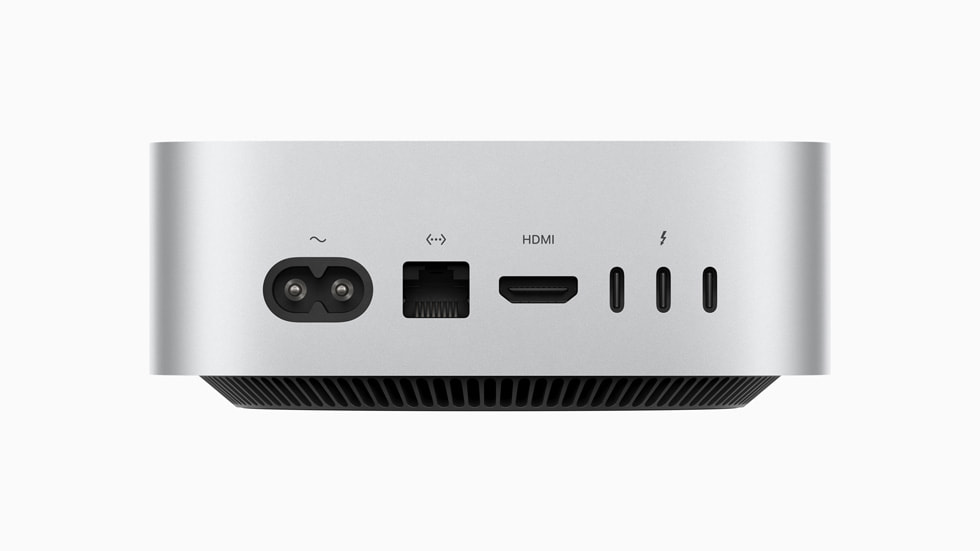
M4 일반형 24GB vs M4 Pro 48GB: 어디서 갈릴까
예산이 넉넉하다면 고민 없이 M4 Pro 64GB를 찍으면 됩니다. 하지만 대다수 직장인과 개인 개발자는 가성비의 마지노선을 찾아야 합니다. 실전에서는 딱 두 가지 선택지로 압축됩니다.
첫 번째 선택지는 M4 기본 칩셋에 램만 24GB로 올린 구성입니다. 가격이 100만 원 초중반대로 끊기면서 Qwen 2.5 14B Coder 모델을 초당 20토큰 안팎으로 부드럽게 뽑아냅니다. VS Code나 커서(Cursor)에 Continue 플러그인 붙여서 사내 보안 코드 자동 완성용으로 쓰기에 부족함이 없습니다.
두 번째 선택지는 M4 Pro 48GB 구성입니다. 200만 원대로 가격이 껑충 뛰지만 메모리 대역폭이 273GB/s로 일반 M4(120GB/s) 대비 두 배 이상 넓습니다. 대역폭이 넓다는 건 토큰 생성 속도가 그만큼 빨라진다는 뜻입니다. 여기에 코딩 지능에서 압도적 평가를 받는 Qwen 2.5 32B 모델이 메모리에 온전히 얹어집니다. 파이썬 복잡한 리팩토링이나 풀스택 디버깅을 로컬에서 막힘없이 돌리고 싶다면, 48GB가 가장 후회 없는 마지노선입니다.
자주 하는 질문
Q. 나중에 램 부족하면 사설 수리업체에서 업그레이드할 수 있나요?
A. 절대 안 됩니다. M4 칩 패키지 내부에 메모리가 함께 통합된 SoC 구조라 외부 확장이 기술적으로 불가능합니다. 처음 살 때 평생 쓸 용량을 정해야 합니다.
Q. 외장 SSD에 모델 가중치를 저장하고 불러와도 속도에 지장 없나요?
A. 썬더볼트 외장 SSD(읽기 2800MB/s 이상)를 쓰면 모델 최초 로딩 시 2~3초 차이 날 뿐, 일단 램에 올라간 뒤의 토큰 생성 속도에는 전혀 영향이 없습니다. 깡통 내장 용량(256GB/512GB) 사고 외장 SSD를 물려 쓰는 게 훨씬 경제적입니다.
Q. 전원 버튼이 밑바닥에 있어서 24시간 켜둘 때 불편하지 않나요?
A. 실사용자들은 맥미니 전원을 끌 일이 거의 없습니다. 맥OS 설정에서 잠자기 해제해 두고 SSH나 원격 데스크톱으로 붙어 쓰는 홈 서버 형태로 운용하기 때문에 바닥 버튼은 사실상 신경 쓸 일이 없습니다.
제품 소개
제품 한줄 소개: 비싼 엔비디아 VRAM 대안으로 로컬 AI 연구와 코딩 자동화를 손바닥 위에서 완성하는 미니 데스크톱 머신.
추천 대상: 사내 코드 유출 걱정 없이 로컬 환경에서 Qwen 코딩 어시스턴트를 24시간 띄워두고 싶은 현업 개발자 및 테크 얼리어답터.
비추천 대상: 16GB 기본형 사서 32B 이상 거대 모델을 쾌적하게 굴릴 수 있을 거라 기대하는 입문자.
구매 전 체크 3가지:
- 내가 주로 돌릴 모델 크기(7B, 14B, 32B)에 맞춰 메모리를 타협 없이 선택했는가? (14B는 최소 24GB, 32B는 최소 48GB)
- 통합 메모리는 사후 업그레이드가 불가능하므로 SSD 용량을 줄이더라도 램 용량을 최우선으로 확보했는가?
- 모니터, 키보드, 마우스가 별도로 없는 단독 본체 제품이므로 기존 주변기기 환경이 준비되어 있는가?