오과장입니다. 오늘은 클라우드 API 비용 청구서를 보고 머리를 싸매다가 "내 노트북에서 직접 AI 모델 돌리겠다"며 5060ti 16gb llm 스펙을 검색 중인 분들을 기준으로 보겠습니다.
매달 나가는 OpenAI나 클로드 API 비용이 10만 원, 20만 원을 넘어가기 시작하면 누구나 로컬 LLM(대형 언어 모델)에 눈을 돌립니다. Ollama 켜고 DeepSeek-R1, Qwen2.5-Coder 같은 오픈소스 모델을 내려받아 인터넷 연결 없이 내 코드와 사내 기밀 문서를 안전하게 분석하고 싶어 합니다. 지극히 합리적인 생각입니다.
하지만 여기서 치명적인 함정에 빠집니다. 데스크톱 그래픽카드인 'RTX 4060 Ti 16GB'나 '5060 Ti 16GB' 이름을 보고 노트북에서도 당연히 16GB VRAM이 나올 거라 착각하고 대충 결제 버튼을 누르는 순간 낭패를 봅니다. 노트북용 모바일 GPU(RTX 5060 Laptop)는 비디오 메모리(VRAM)가 8GB로 제한되어 있습니다. 모델 파라미터가 14B, 32B로 넘어가면 VRAM 용량이 부족해 Out of Memory(OOM)가 터지거나, 시스템 RAM으로 오프로딩되면서 토큰 생성 속도가 초당 40토큰에서 초당 3토큰으로 곤두박질칩니다. 속 터집니다.
노트북으로 로컬 AI를 돌리려면 딱 세 가지가 맞물려야 합니다. 첫째, GPU의 텐서 코어를 100% 쥐어짜는 TGP(전력 공급량). 둘째, 장시간 추론 시 스로틀링을 막아줄 쿨링 솔루션. 셋째, VRAM 부족분을 받아줄 시스템 RAM의 대역폭과 자가 증설 슬롯입니다. 실무에서 바로 통하는 3가지 모델을 선별했습니다.
- 최적의 상황: 외부 API 비용 없이 Ollama, LM Studio를 통해 7B~14B 양자화 모델(Q4/Q5)을 로컬에서 초당 30~50토큰으로 쾌적하게 돌리려는 개발자 및 AI 연구자.
- 절대 사면 안 되는 사람: VRAM 16GB 풀로드가 필요한 FP16 무손실 32B 이상 모델을 외장 GPU 단독으로 파인튜닝하려는 분 (이 목적은 데스크톱 3090/4090 24GB 중고나 클라우드 렌탈로 가셔야 합니다).
- 후회 없는 옵션: RAM은 무조건 24GB~32GB 이상 확보하세요. 온보드 16GB 모델은 VRAM 초과 시 블루스크린이나 빌드 튕김이 발생하므로 슬롯 확장 가능한 기종이 필수입니다.
1. [180만 원대 로켓배송 실속형 & 24GB RAM 기본 장착] HP 2026 오멘 15 RTX 5060
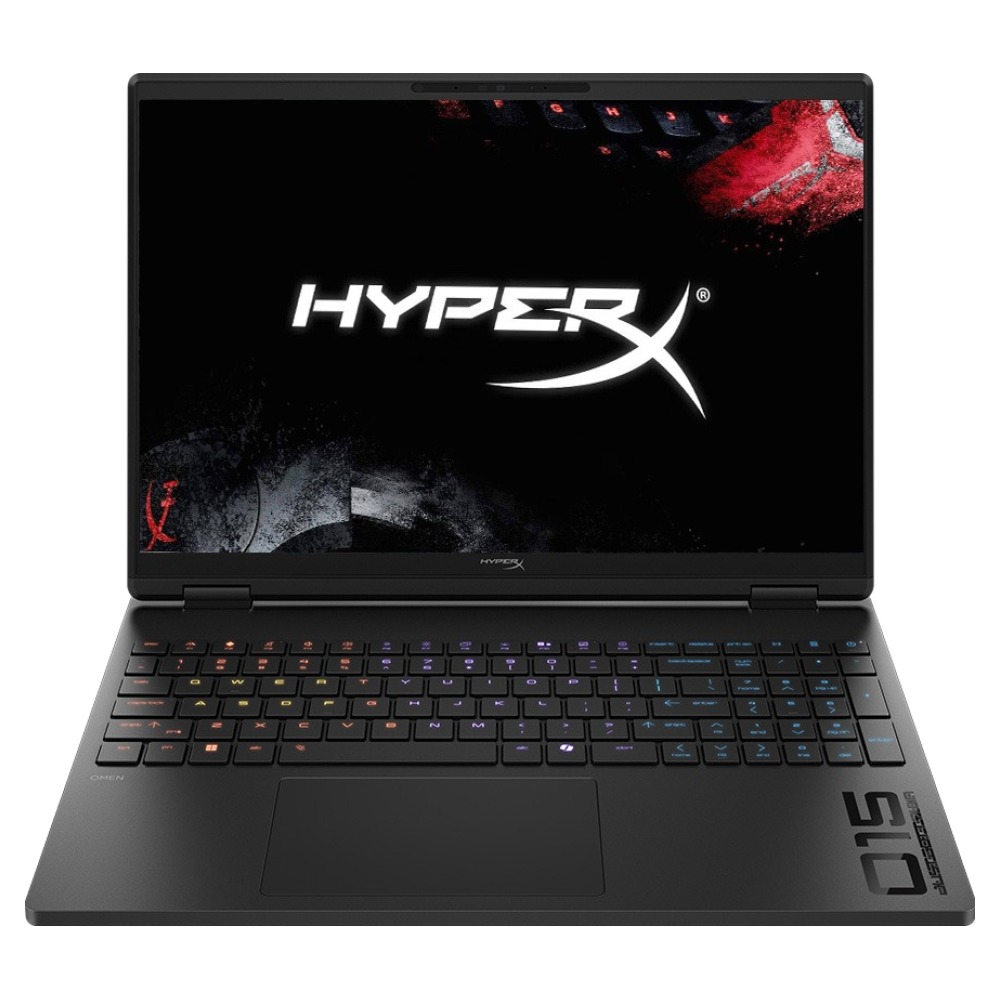
가장 실속 있는 선택입니다. 가격부터 보시죠. 180만 원대에 로켓배송으로 바로 다음 날 아침 손에 쥡니다.
이 모델의 최대 강점은 제조사가 처음부터 24GB DDR5 메모리와 1TB NVMe SSD를 꽂아 출고한다는 점입니다. 보통 게이밍 노트북들이 16GB 램에 512GB SSD를 넣어두고 출고해서, 구매하자마자 하판을 뜯고 부품을 추가로 사서 끼워야 하는 번거로움이 있습니다. 오멘 15는 그럴 필요가 없습니다. 박스 까고 윈도우 설치한 뒤 Ollama 깔면 끝납니다.
로컬 LLM 구동 시 24GB 램의 위력은 실전에서 터집니다. RTX 5060의 VRAM 8GB에 Qwen2.5-Coder 7B나 Llama-3.1 8B 모델(약 4.5~5.5GB 점유)을 100% 올려서 초당 45토큰 이상의 번개 같은 속도로 추론합니다. 만약 14B 모델(약 9GB 점유)을 돌리더라도 부족한 1~2GB 레이어가 24GB 시스템 램으로 매끄럽게 넘어가 병목 없이 작동합니다. 오멘 특유의 템페스트 쿨링 솔루션 덕분에 1시간 연속 배치 추론을 돌려도 키보드 팜레스트가 미지근하게 유지됩니다.
- 강점: 180만 원대 뛰어난 가성비, 24GB RAM + 1TB SSD 기본 탑재(자가 증설 불필요), 안정적인 템페스트 쿨링 솔루션, 당일 주문 익일 새벽 도착.
- 약점: 프리도스 모델이므로 윈도우 11 직접 설치 필요, 무게 약 2.3kg으로 어댑터 포함 시 휴대성 타협 필요.
- 추천 대상: 하판 뜯기 귀찮고 100만 원대 예산 안에서 넉넉한 24GB 메모리로 7B~14B 로컬 LLM을 즉시 구동하고 싶은 개발자.
👉 HP 2026 오멘 15 (24GB+1TB) 로켓배송 최저가 및 카드할인 확인하기
2. [140W 풀전력 TGP & 내구성 끝판왕] 에이수스 2026 TUF 게이밍 F16 RTX 5060
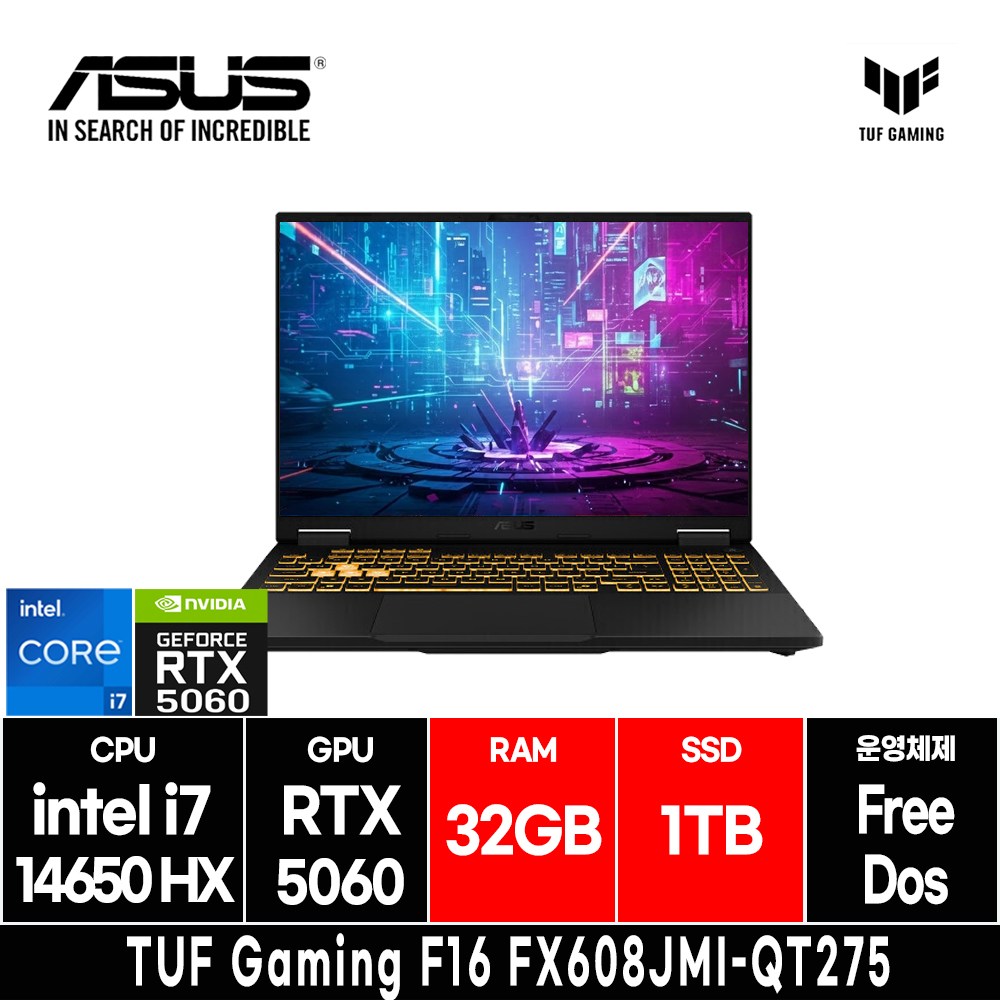
연속 연산의 안정성과 하드웨어 내구성을 최우선으로 본다면 TUF 게이밍 F16이 정답입니다.
인텔 14세대 코어 i7 고성능 프로세서와 엔비디아 지포스 RTX 5060을 조합했습니다. 여기서 핵심은 그래픽카드에 들어가는 전력(TGP)입니다. 슬림형 랩탑에 들어가는 저전력 60W~75W 세팅이 아니라, 140W 최대 TGP 풀파워를 아낌없이 밀어 넣습니다. LLM 추론 시 텐서 코어가 쉬지 않고 풀가동될 때 클럭 다운 없이 일정한 연산 속도를 방어해 줍니다.
미국 국방성 밀스펙(MIL-STD-810H) 충격·진동·온도 테스트를 통과한 단단한 프레임도 장점입니다. 연구실이나 사무실에서 밤새도록 RAG(검색 증강 생성) 벡터 임베딩을 파이프라인으로 돌려놓아도 팬 2개가 열기를 하판과 측면으로 맹렬하게 뽑아냅니다. 듀얼 SO-DIMM 슬롯을 지원하므로 필요에 따라 나중에 32GB, 64GB까지 자가 증설이 가능합니다.
- 강점: 140W 풀전력 TGP로 병목 없는 텐서 연산, 밀스펙 인증 내구성 섀시, 최대 64GB까지 증설 가능한 듀얼 램 슬롯, 정숙 모드 세부 튜닝 지원.
- 약점: 16인치 폼팩터로 무게 약 2.27kg, 풀로드 가동 시 팬 풍절음 발생(조용한 독서실 지양).
- 추천 대상: 긴 시간 동안 대량의 텍스트 문서 임베딩 및 고부하 추론을 연속으로 걸어두는 AI 개발자.
👉 에이수스 2026 TUF F16 RTX 5060 실시간 잔여 재고 및 특가 확인하기
3. [i9-14900HX 괴물 연산 & RTX 5070 상급기] MSI 2026 크로스헤어 16 HX
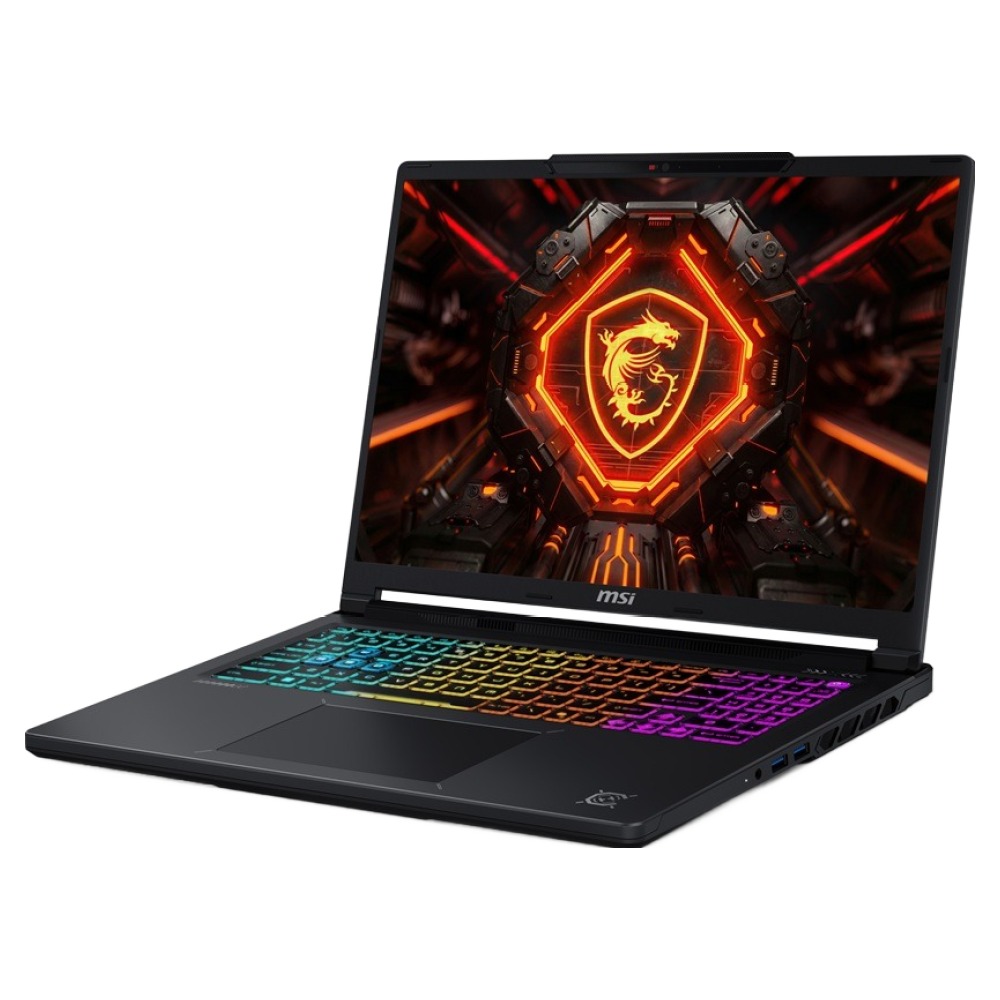
돈을 조금 더 쓰더라도 추론뿐 아니라 데이터 전처리와 미세조정(LoRA)까지 랩탑에서 끝내고 싶다면 이 녀석입니다.
머리 역할을 하는 CPU가 인텔의 끝판왕인 코어 i9-14900HX(24코어 32스레드)입니다. 대규모 텍스트 토크나이징이나 판다스(Pandas) 데이터 전처리 작업을 걸어보면 일반 6코어, 8코어 랩탑과는 차원이 다른 속도로 연산을 끝내버립니다. 여기에 그래픽카드는 상급기인 지포스 RTX 5070을 얹었습니다. 더 많은 CUDA 코어와 텐서 코어로 Ollama에서 DeepSeek-R1 14B Q4 양자화 모델을 돌릴 때도 지연 시간(Latency) 없이 매끄러운 타이핑 속도로 답변을 쏟아냅니다.
화면도 16인치 16:10 비율의 QHD+(2560x1600) 240Hz 고해상도 디스플레이입니다. 코드 창 두 개를 좌우로 띄워두고 터미널 창을 아래에 깔아도 글자가 뭉개지지 않고 선명합니다. 쿨러부스트 5 기술로 듀얼 팬과 6개 히트파이프가 열을 빼내어 장시간 벤치마크 테스트에서도 성능 저하가 극히 적습니다.
- 강점: i9-14900HX 24코어 괴물 CPU 연산력, 상급기 RTX 5070 탑재로 빠른 추론 토큰 속도, QHD+ 240Hz 선명한 대화면, 쿨러부스트 5 강력한 냉각.
- 약점: 200만 원대 후반 가격대, 풀로드 시 240W 대용량 어댑터 무게 동반.
- 추천 대상: 단순 추론을 넘어 파이썬 데이터 전처리와 로컬 AI 엔지니어링 환경을 데스크톱 없이 랩탑 하나로 완성하려는 엔지니어.
👉 MSI 2026 크로스헤어 16 HX (i9 + RTX 5070) 로켓배송 실시간 재고 확인하기
실구매 한눈에 비교: 당신에게 맞는 기종은?
- 180만 원대 로켓배송 가성비 종결 & 24GB 램: 추가 지출 없이 바로 14B 모델까지 맛보고 싶다면 HP 2026 오멘 15가 원탑입니다.
- 140W 풀전력 TGP & 단단한 내구성: 밤샘 임베딩 연산과 향후 64GB 램 증설을 노린다면 에이수스 TUF 게이밍 F16을 고르세요.
- i9-14900HX 24코어와 RTX 5070 하이엔드: 전처리 속도와 QHD+ 대화면 코딩 쾌적함을 타협할 수 없다면 MSI 크로스헤어 16 HX가 종결입니다.
자주 하는 질문 (Q&A)
Q. '5060ti 16gb llm' 검색어가 많이 보이는데 노트북용 5060 Ti 16GB는 없나요?
A. 없습니다. 5060 Ti 16GB(또는 4060 Ti 16GB)는 데스크톱용 규격입니다. 노트북용 지포스 RTX 5060은 VRAM이 8GB로 고정되어 있습니다. 따라서 노트북에서 로컬 LLM을 원활하게 굴리려면 시스템 RAM을 24GB~32GB 이상 넉넉히 확보하여 VRAM 부족분을 오프로딩으로 흡수하는 설계가 필수입니다.
Q. RTX 5060 8GB로 DeepSeek-R1이나 Qwen2.5 14B 모델이 진짜 돌아가나요?
A. 네, 4비트 양자화(Q4_K_M) 모델 기준 14B 모델은 가중치 파일 용량이 약 8.5~9GB 안팎입니다. VRAM에 대부분 적재되고 부족한 1GB 남짓만 시스템 램에 걸치기 때문에 초당 25~35토큰의 실사용 가능한 쾌적한 속도로 답변이 출력됩니다. 7B~8B 모델은 100% VRAM에 들어가 초당 45토큰 이상으로 날아다닙니다.
Q. 로컬 LLM 돌릴 때 팬 소음이 도서관이나 독서실에서 감당 가능한가요?
A. 풀로드 추론 시에는 팬이 45~50dB 이상으로 돕니다. 조용한 독서실에서는 눈치 보입니다. 전용 소프트웨어(오멘 게이밍 허브, 아머리 크레이트 등)에서 '정숙(Silent)' 프로파일로 전력을 60W~80W 선으로 제한하면 팬 소음은 잡히지만 토큰 생성 속도가 20~30% 낮아집니다. 개방형 카페나 사무실, 개인 방에서 쓰시는 것을 권장합니다.
결국 로컬 LLM 노트북의 핵심은 이름뿐인 마케팅 수치에 현혹되지 않고, 내 예산 안에서 TGP와 메모리 대역폭을 가장 알차게 확보하는 것입니다. 매달 나가는 API 비용을 아끼고 나만의 프라이빗 AI 작업실을 완성해 보시기 바랍니다.