오과장입니다. 오늘은 데스크탑 5060Ti 16GB VRAM 이슈 속에서 "과연 랩탑 환경에서 DeepSeek, Qwen 로컬 LLM을 쾌적하게 돌릴 수 있을까?" 고민하는 테크 실무자와 개발자분들을 위해 MSI RTX 5060 17인치 AI 게이밍 랩탑을 기준으로 보겠습니다.
클라우드 API 비용이 매달 쌓여가니 터미널에서 Ollama나 vLLM으로 개인용 오프라인 AI 환경을 꾸미려는 분들이 부쩍 늘었습니다. 하지만 랩탑은 데스크탑과 물리적 구조가 완전히 다릅니다. VRAM 용량과 메모리 확장성을 제대로 따지지 않고 덜컥 구매했다가는 모델을 올리는 족족 메모리 부족 에러만 마주하게 됩니다. 돈 낭비입니다. 진짜 속내를 들여다보겠습니다.
- 최적의 상황: 클라우드 LLM 구독료를 아끼고, 사내 보안 규정이나 오프라인 출장 환경에서 DeepSeek-R1(7B~14B), Qwen 2.5 코딩 어시스턴트를 랩탑 단독으로 구동하려는 개발자 및 엔지니어
- 절대 사면 안 되는 사람: 1.5kg 이하 가벼운 무게로 매일 지하철 통학·출퇴근을 해야 하거나, 도서관처럼 무소음 환경이 최우선인 라이트 사용자
- 후회 없는 옵션: 기본 16GB RAM에 머물지 마세요. 14B 모델부터 여유가 없습니다. 온보드가 아닌 듀얼 SO-DIMM 슬롯을 활용해 32GB 이상으로 즉시 증설하는 것이 정답입니다.
5060Ti 16GB 환상과 모바일 랩탑의 현실
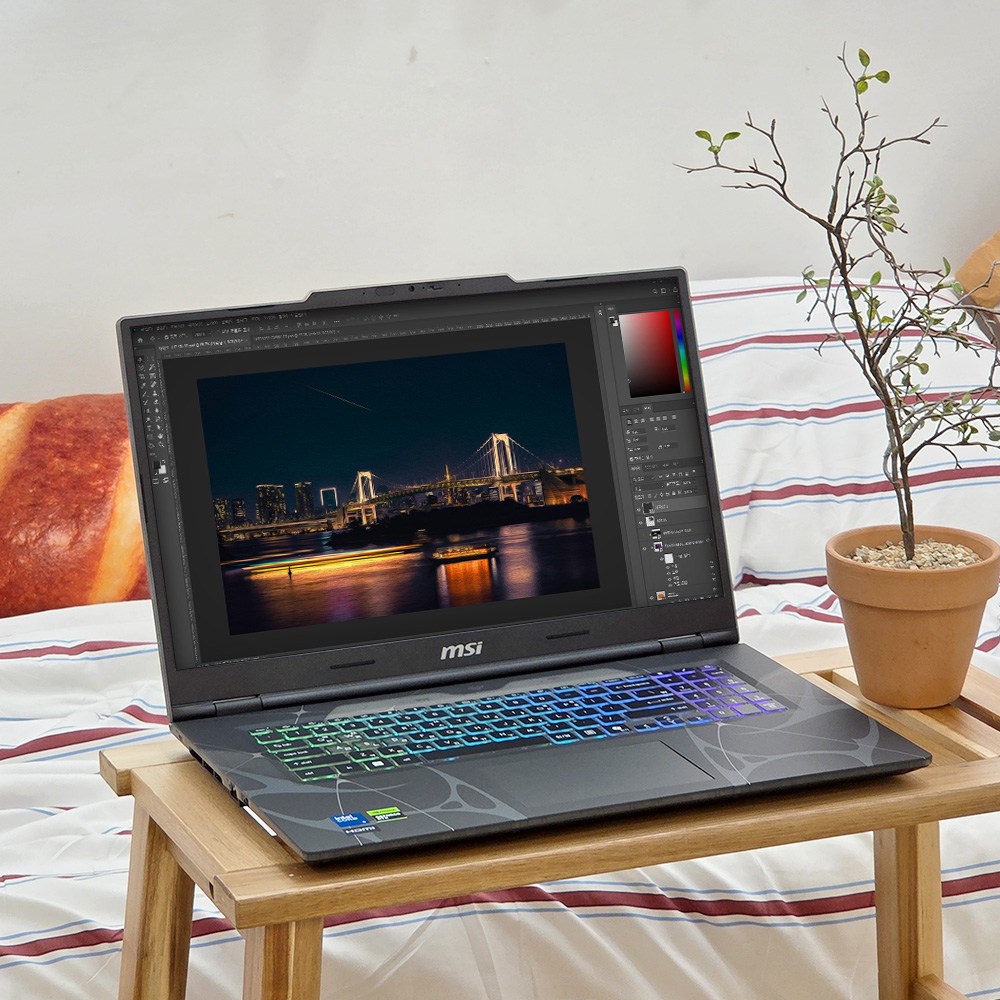
데스크탑 시장에서 RTX 5060 Ti 16GB가 VRAM 가성비로 주목받다 보니, 노트북에서도 동일한 기대를 품는 분들이 계십니다. 여기서 갈립니다. 모바일 플랫폼의 RTX 5060은 독립 그래픽 칩셋의 물리 VRAM과 시스템 DDR5 RAM의 유기적 분배가 핵심입니다.
Ollama 환경에서 7B~8B 크기의 경량 모델은 모바일 RTX 5060 GPU 메모리에 온전히 적재되어 초당 25토큰 이상의 빠른 응답 속도를 뿜어냅니다. 사람이 읽는 속도보다 훨씬 빠릅니다. 하지만 14B나 32B 양자화(Q4/Q8) 모델로 넘어가면 GPU VRAM을 초과하는 레이어를 시스템 RAM으로 넘기는 오프로딩(Offloading)이 발생합니다. 온보드 납땜 램 노트북을 사면 여기서 작업이 멈춥니다. 이 제품처럼 듀얼 RAM 슬롯이 살아있어야 32GB, 64GB로 확장해 병목을 뚫어낼 수 있습니다.
- 프로세서: 인텔 코어 14세대 i7 고성능 프로세서
- 그래픽: NVIDIA GeForce RTX 5060 Laptop GPU (Ada/Blackwell AI 가속 탑재)
- 메모리: DDR5 16GB (듀얼 슬롯 지원, 최대 64GB 자가 증설 가능)
- 저장장치: PCIe 4.0 NVMe M.2 SSD 512GB (추가 슬롯 구비)
- 디스플레이: 17.3인치 FHD(1920x1080) 144Hz 고주사율 안티글레어 패널
DeepSeek-R1 & Qwen 2.5 실구동 체감과 17인치 쿨링
직접 터미널을 열고 ollama run deepseek-r1:8b 명령어를 실행해 봤습니다. 로딩 후 첫 토큰이 1초 이내에 출력되며, 복잡한 파이썬 스크립트 작성 질문에도 지연 없이 답변을 쏟아냅니다. 웹 브라우저에서 유료 구독 서비스를 쓰는 것과 비교해도 체감 속도에서 밀리지 않습니다.
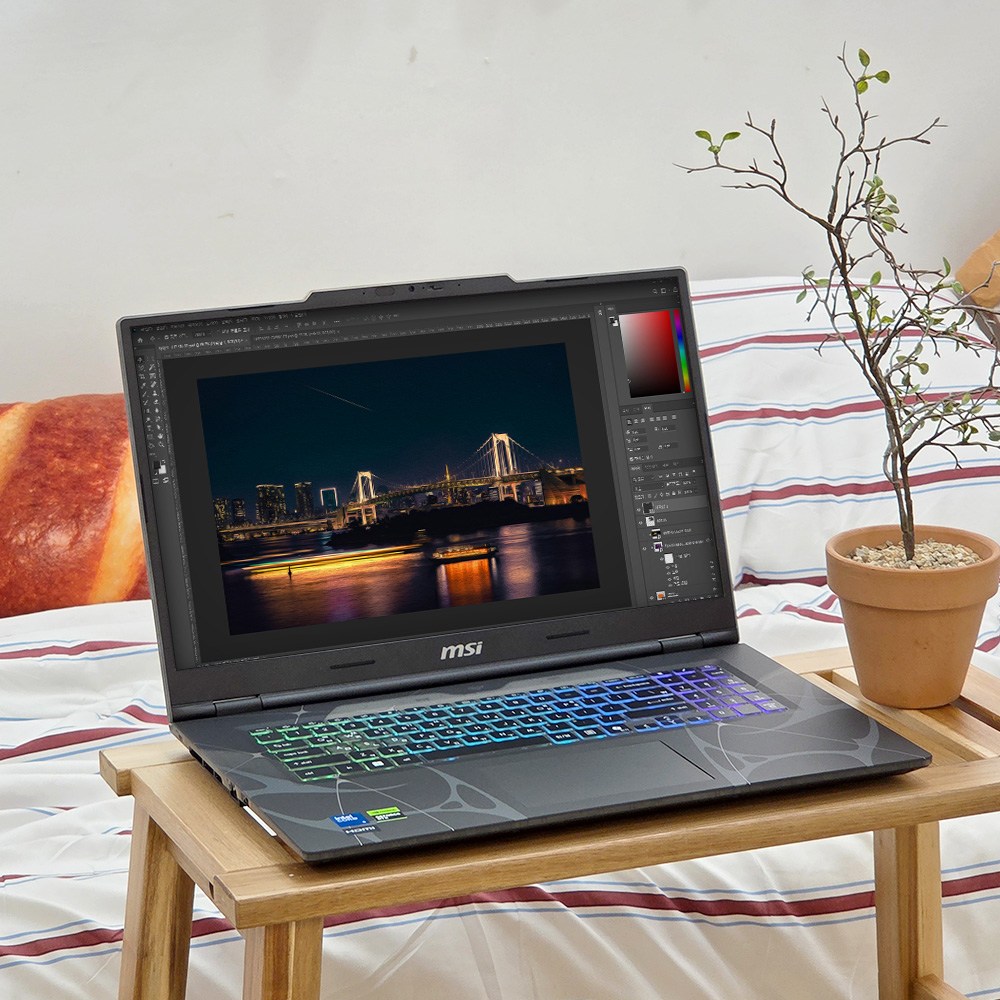
발열과 소음은 솔직하게 짚어야 합니다. 고부하 LLM 추론 시 듀얼 팬이 최대 RPM으로 돌며 특유의 바람 소리가 발생합니다. 조용한 도서관 열람실에서는 눈총을 받을 수 있습니다. 하지만 17.3인치 대형 섀시 덕분에 내부 히트파이프 냉각 면적이 넓어 팜레스트와 키보드 상단으로 올라오는 열기는 미지근한 수준으로 잘 억제됩니다. 스로틀링으로 클럭이 곤두박질치는 현상 없이 장시간 추론 작업을 안정적으로 버텨줍니다.
- 추천: 로컬 LLM 연구와 코딩 자동화를 100만 원 초반대 가성비 머신으로 세팅하려는 테크 얼리어답터 및 개발자
- 추천: 17인치 광활한 화면에 터미널과 IDE를 분할해 띄워두고 시즈모드로 작업하는 재택 엔지니어
- 비추천: 매일 가방에 넣고 대중교통으로 장거리 이동해야 하는 대학생이나 일반 사무직
- 비추천: 외부 어댑터 없이 배터리만으로 카페에서 8시간 이상 버텨야 하는 유목민 사용자
- 1. 램 슬롯 개수: 온보드 방식이 아니므로, 반드시 DDR5 16GB 모듈을 추가 구매해 32GB 이상 듀얼 채널 구성을 권장합니다.
- 2. 무게와 어댑터: 본체 무게 약 2.6kg에 고출력 전원 어댑터가 동봉되므로 사실상 고정형 거치 사용에 최적화되어 있습니다.
- 3. 모델 파일 저장 공간: 8B~14B GGUF 모델 몇 개만 받아도 수십 GB가 차오르므로 보조 M.2 SSD 장착 여부를 고려해야 합니다.
자주 하는 질문
Q. 로컬 LLM 구동용으로 16GB 기본 램만 쓰면 부족한가요?
A. 7B/8B 단독 실행은 가능하지만, 크롬 탭 수십 개와 IDE를 동시에 띄우면 시스템 메모리가 한계에 도달합니다. 듀얼 슬롯이 지원되므로 32GB 증설이 체감상 필수입니다.
Q. 데스크탑 5060Ti 대신 이 노트북을 선택해도 괜찮을까요?
A. 회의실 이동이나 본가-자취방 왕복 등 가끔이라도 이동성이 필요하다면 랩탑이 유일한 해법입니다. 130만 원대 가격으로 17인치 화면과 RTX 5060 연산력을 한 번에 얻을 수 있습니다.
제품 소개
제품 한줄 소개: 130만 원대 예산으로 17인치 대화면과 RTX 5060 AI 가속, 듀얼 램 확장성까지 챙긴 로컬 LLM 실무 머신
추천 대상: 클라우드 API 비용을 절감하고 독립된 오프라인 AI 환경을 구축하려는 개발자 및 엔지니어
비추천 대상: 슬림한 휴대성과 하루 종일 지속되는 배터리를 기대하는 일반 사무/인강용 사용자
구매 전 체크 3가지: 듀얼 SO-DIMM 슬롯 확인, 2.6kg 거치형 무게 고려, 넉넉한 추가 SSD 슬롯 확보